pi-okf-memory
会话记忆 → OKF 知识沉淀的 pi 扩展。把会话中高价值内容按 OKF v0.1 规范自动沉淀为长期记忆,跨会话自动唤起,并基于权重持续学习。Session-to-OKF long-term memory for pi with predictive recall, uncertainty-driven capture and reinforcement feedback.
Package details
Install pi-okf-memory from npm and Pi will load the resources declared by the package manifest.
$ pi install npm:pi-okf-memory- Package
pi-okf-memory- Version
0.1.1- Published
- Sep 13, 2026
- Downloads
- 288/mo · 288/wk
- Author
- wangzhiqi
- License
- MIT
- Types
- extension
- Size
- 394.3 KB
- Dependencies
- 0 dependencies · 1 peer
Pi manifest JSON
{
  "extensions": [
    "./src/pi/index.ts"
  ]
}
Security note
Pi packages can execute code and influence agent behavior. Review the source before installing third-party packages.
README
pi-okf-memory



会话记忆 → OKF 知识沉淀。让 pi 跨会话记住你。
把会话里高价值的内容按 OKF v0.1 规范自动沉淀成长期记忆,下次开新会话自动唤起。每次选择、跳过、纠正都是学习信号 —— 用得越久,召回越准。
English TL;DR —
pi-okf-memorydistills high-value content from your pi sessions into durable OKF v0.1 Markdown files and recalls it in later sessions. The memory is yours: plain files you can read,git, and edit. Weighted recall sharpens with every pick and skip. Install:pi install npm:pi-okf-memory(orpi install git:github.com/ZHI-QI/pi-okf-memory). One command:/okf. Six tools:okf_remember/okf_search/okf_read/okf_forget/okf_graph/okf_feedback. Full English README →
为什么需要它
pi 每次开新会话都从零开始。你反复交代同样的事:
「我用 pnpm 不用 npm」 「经营数据走鼎赞 SaaS 的 MySQL,别翻本地文件」 「上季度定了 React 18 + Vite,别再问我前端用什么」
pi-okf-memory 把这些沉淀成文件。它是你的,不是黑盒:
- 可读 —— 就是 Markdown,直接打开看、
git管、随时手改 - 可迁 —— 一个目录,拷走就是完整记忆
- 不编造 —— 检索不到会明确说「记忆库没有」,不会假装记得
安装
pi install git:github.com/ZHI-QI/pi-okf-memory        # 从 GitHub
pi install /path/to/pi-okf-memory                     # 从本地 checkout
pi -e /path/to/pi-okf-memory/src/pi/index.ts          # 试用,不写配置
零运行时依赖,无需构建步骤 —— pi 用 jiti 直接加载 TypeScript,并通过别名提供 typebox 与 @earendil-works/pi-*。
用法
你不需要学任何命令
装好后,插件会注入一段「记忆纪律」,pi 会自己判断该记什么、该查什么:
你: 记住,我的三家门店是韶山/湘乡/塘厦,共用局域网共享文件夹
    → pi 自行判断价值、去重、写入、建索引

你: 查询经营数据走哪里?
    → pi 先 okf_search 召回,再基于记忆回答(而不是瞎猜或翻文件)

你: 查一下记忆里关于门店的
    → 显式触发检索
6 个工具(pi 自主调用)
| 工具 | 作用 |
|---|---|
okf_remember |
写入一条记忆(自动类型校验 → 去重 → 小节级合并 → 落盘) |
okf_search |
按 相关度 × 权重 × 近因 排序召回;命中 TechChoice 附候选表 |
okf_read |
精读某条全文(含交叉链接),并记一次使用反馈 |
okf_forget |
撤回一条(默认保留文件可追溯,可选删文件) |
okf_graph |
导出图谱 JSON(nodes / edges / timeline) |
okf_feedback |
用户选中 +1.0 / 跳过 −0.5,直接调权重 |
命令:一个 /okf 就够
只注册一个命令,子命令可 Tab 补全(输入 /okf 后按 Tab)。
| 命令 | 作用 |
|---|---|
/okf |
记忆库状态:根目录 / 概念数 / 权重榜 |
/okf search <关键词> |
检索(短别名 /okf s) |
/okf graph |
导出单文件自包含交互式图谱 HTML 并打开(短别名 /okf g) |
/okf consolidate |
立即跑一次巩固(衰减 + 归档)(短别名 /okf c) |
/okf help |
列出全部子命令 |
什么值得记
| 记 ✅ | 不记 ❌ |
|---|---|
| 新背景事实 / 偏好 / 习惯 | 寒暄、过程性问答 |
| 拍板的决策及理由 | 单轮临时任务 |
| 可复用方法论 / 流程 / 教训 | 已有记忆的重复表述 |
| 你纠正它的时候(最强信号) | 未验证的猜测(可归入 Idea 等成熟) |
| 被确认的反直觉结论 | |
| 技术选型(前端/后端/语言/方案/配置) |
工作原理
捕获 ──→ 概念化 ──→ 沉淀 ──→ 唤起
 │        │         │        │
 │        │         │        └─ 相关度 × 权重 × 近因 排序,写回使用反馈
 │        │         └─ type 校验 → 标题去重 → 小节级合并 → index/log 更新
 │        └─ 8 类型词表 + OKF v0.1 frontmatter 校验
 └─ pi 依据「记忆纪律」判断本轮是否产生值得沉淀的新知识
权重学习
召回评分是 relevance × weight × recency。权重随你的行为变化:
| 行为 | 权重 |
|---|---|
| 用户选中 / 确认采用 | +1.0 |
| 用户跳过 / 否定 | −0.5 |
| 被精读使用 | +0.1 |
| 30 天未触碰 | 开始衰减(0.9^超出天数/30) |
| 权重 < 0.3 | 归档(inactive,不删除,可复活) |
| 归档后被重新使用 | 回到 ≥ 0.6 |
衰减是增量式的:时间没流逝就不会重复扣血 —— 反复调用巩固与只调用一次结果完全相同。
技术选型三档规则(内置协议)
针对前端/后端/语言/方案/配置这类选型:
- 命中 2+ 候选 → 全部展示给你选,绝不擅自决定
- 命中 1 个候选 → 直接使用
- 你未指定技术但命中维度关键词(如「前端」)→ 按该维度记忆处理
- 你提出新方案/切换/配置 → 追加式更新,不覆盖旧候选(保留 v1→vN 轨迹)
设计依据:每个机制都追得到记忆研究
权重、衰减、归档、检索强化 —— 这些不是拍脑袋定的,各自对应认知心理学与神经科学里的经典结论。
| 机制 | 文献 | 本项目实际怎么做 |
|---|---|---|
| 遗忘曲线 | Ebbinghaus (1885) Über das Gedächtnis | decayFactor():30 天宽限期后按 0.9^((t−30)/30) 幂衰减 |
| 记忆可用性追踪「需要概率」 | Anderson & Schooler (1991), Psychological Science 2(6):396–408 | 权重 = 使用频率(选中 +1.0 / 精读 +0.1)+ 近因 1/(1+days/30) |
| 存储强度 ≠ 提取强度 | Bjork & Bjork (1992), From Learning Processes to Cognitive Processes | 归档只置 state: inactive,文件不删;再用可把权重抬回 |
| 提取练习效应(测试效应) | Roediger & Karpicke (2006), Psychological Science 17(3):249–255 | okf_read 精读一次即写回权重反馈 |
| 激活扩散 | Collins & Loftus (1975), Psychological Review 82(6):407–428 | /okf graph 命中后沿交叉链接 BFS 传导点亮 |
| 半衰期回归 | Settles & Meeder (2016), ACL pp.1848–1858 | PARAMS 把衰减参数化(DECAY_DAYS/DECAY_FACTOR),可调 |
| 长时程增强(LTP) | Bliss & Lømo (1973), J. Physiol. 232(2):331–356 | 每次使用权重递增,上限 10 |
边界说明(不吹)
上面是设计类比,不是「本插件实现了神经科学」。差别具体在哪:
- 权重是一张 JSON 表,不是脉冲神经网络 —— 没有神经元、没有突触、没有膜电位
- 交叉链接靠写入时显式传
related,不做共现自动统计 —— 所以不是 Hebbian 自动联想 - 激活扩散只用于可视化,不参与权重计算
- 半衰期是固定参数,没做个性化拟合 —— 而 Settles & Meeder 那篇的核心恰恰是「拟合」
写清楚这些,是因为「参考了哪些研究的结论」和「实现了多少」是两件事。 知道边界在哪,你才能判断它适不适合你的场景。
记忆库结构
默认 ~/.pi/agent/okf-memory/(环境变量 OKF_MEMORY_ROOT 可覆盖):
~/.pi/agent/okf-memory/
├── index.md            ← 渐进式目录(okf_version: "0.1")
├── log.md              ← 变更历史(## YYYY-MM-DD)
├── fact/               ← 背景事实
├── preference/         ← 偏好
├── decision/           ← 决策(三段式:数据/分析/结论)
├── method/             ← 方法论
├── insight/            ← 洞察
├── idea/               ← 未成型灵感
├── lesson/             ← 经验教训
├── techchoice/         ← 技术选型(Options 候选表 + Active)
└── .meta/weights.json  ← 学习权重(点目录,不污染 OKF 符合性)
概念 ID 就是相对路径(如 fact/门店布局),交叉链接用包内绝对路径 [文字](/fact/门店布局.md)。
可视化图谱
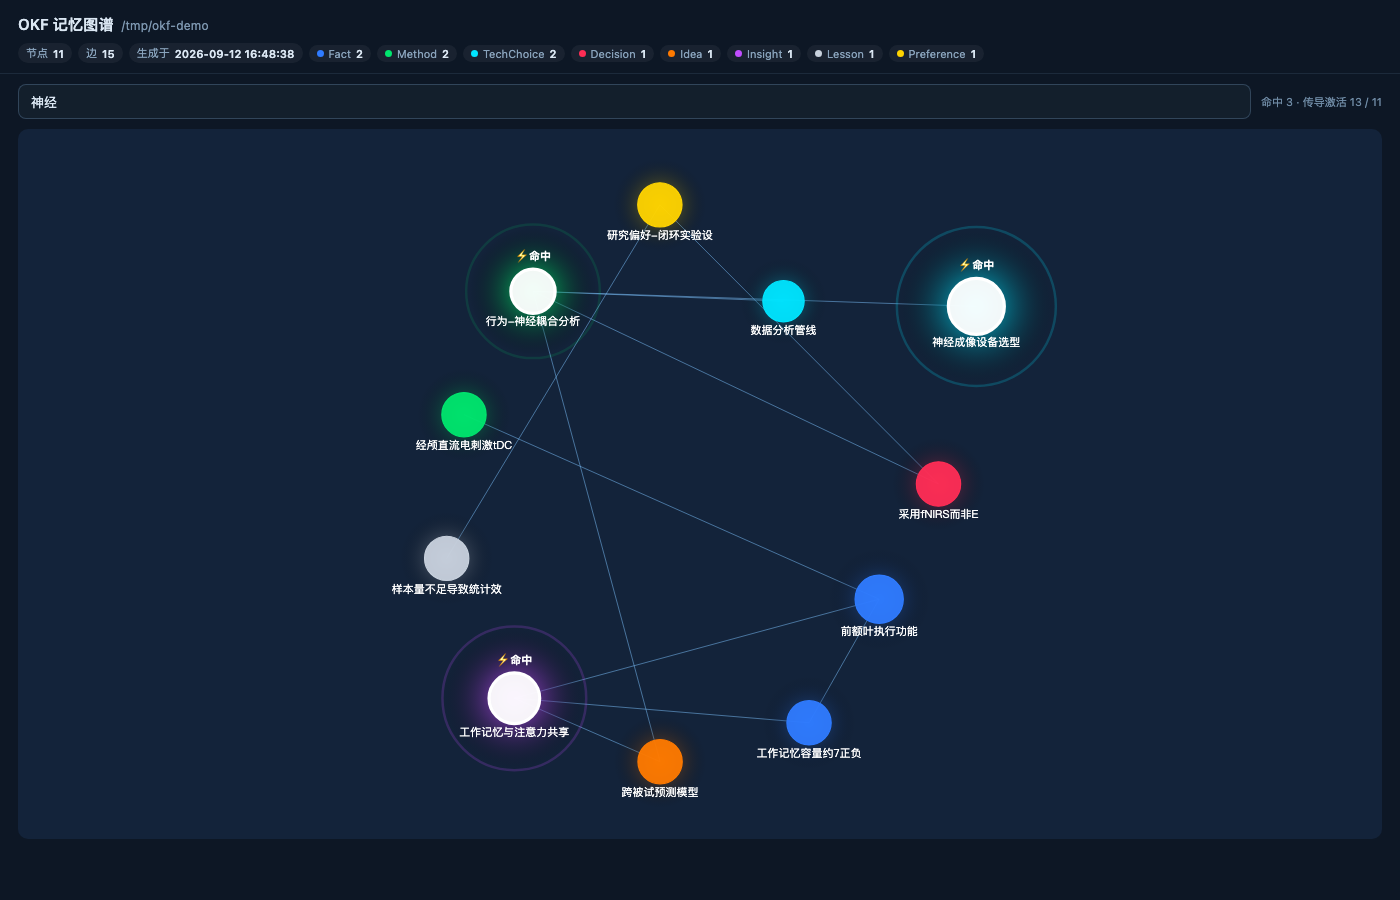
/okf graph 生成单文件自包含 HTML(无 CDN、无构建产物),双击即可打开或分享:
- 节点大小 = 权重,颜色 = 类型,虚线描边 = 已归档
- 悬停看详情,滚轮缩放,拖拽平移,可拖动节点
- 搜索命中 → 白边 + 脉冲光环 +
⚡命中,并沿交叉链接 BFS 传导点亮关联记忆
配置
| 项 | 方式 | 默认 |
|---|---|---|
| 记忆库根目录 | 环境变量 OKF_MEMORY_ROOT |
~/.pi/agent/okf-memory/ |
| 学习参数 | src/server/learning.ts 的 PARAMS |
见上「权重学习」 |
调参入口都集中在 PARAMS:SELECT_DELTA / SKIP_DELTA / HIT_DELTA / DECAY_DAYS / DECAY_FACTOR / ARCHIVE_THRESHOLD / ARCHIVE_RECOVER / CONSOLIDATE_INTERVAL_MS。
同一份核心也驱动 dsh 插件
运行时无关的核心(src/server/*)零宿主耦合 —— 外部依赖只有 node:fs / node:path / node:os,只有 src/server/index.ts 是 dsh 适配层。因此 dsh 插件 dsh-okf-memory 与 pi 扩展 pi-okf-memory 共享同一实现:
| pi(本仓库主场) | dsh | |
|---|---|---|
| 适配层 | src/pi/index.ts |
src/server/index.ts |
| 默认记忆库 | ~/.pi/agent/okf-memory/ |
~/.dsh/memory/ |
| 提示注入 | pi.on("before_agent_start") |
ctx.systemPrompt.section() |
| 图谱 | /okf graph 导出 HTML |
web 对话视图标签 |
| 工具 | 6 | 5 |
OKF_MEMORY_ROOT 两个宿主都认 —— 指向同一目录即可共享记忆库。
开发与测试
pnpm install
pnpm test          # typecheck + build + 6 套件,250 断言,离线确定性
pnpm test:e2e      # 真实模型端到端(需 token),9 断言
| 层 | 脚本 | 证明什么 |
|---|---|---|
| 类型对账 | tsc -p tsconfig.typecheck.json |
适配层用法符合 pi 真实 .d.ts |
| 核心功能 | scripts/smoke.js |
store / concept / dedupe / learning / recall / graph |
| dsh 集成 | scripts/integration.js |
mock dsh ctx 下 5 工具全链路 |
| pi 集成 | scripts/pi-integration.js |
mock pi API 下 6 工具 + 4 命令 + schema 校验 |
| pi 真实 RPC | scripts/pi-rpc-commands.js |
命令真的被真实 pi 进程识别并执行 |
| 真实模型 E2E | scripts/pi-e2e-model.js |
模型真的调工具、真的落盘、真的跨会话召回 |
为什么必须有最后两层:自写 mock 只能证明「代码符合我的假设」,证明不了假设本身。本项目的第一个真实 bug 就是这样漏掉的 —— 模型从不知道要传 related 参数,导致真实使用下图谱恒为零边孤岛,而 mock 测试全绿。
注意:tsdown(rolldown)只剥离类型、不做类型检查,所以 pnpm build 通过 ≠ 类型正确,typecheck 是独立一层。
发布到 npm
发布由 .github/workflows/npm-publish.yml 负责,认证走 Trusted Publishing(OIDC)—— 不需要任何 npm token。
为什么不用 token
npm 在 2026 年收紧了 token 发布:
- 自 2025-11 起不再支持经典 access token,只认 granular token
- granular token 里「绕过 2FA」的那类,自 2026-07-31 起也不能再直接发布
(实测报
403 You may not perform that action with these credentials)
所以 CI 发布的正路是 OIDC:npm 用本次 workflow 的 OIDC 身份换一个短时 token,
无需存储任何长期凭据。workflow 里所需的全部权限就是 id-token: write。
首次使用前:在 npmjs.com 配一次 Trusted Publisher
打开 https://www.npmjs.com/package/pi-okf-memory/access → Trusted Publisher → 选 GitHub Actions,填:
| 字段 | 值 |
|---|---|
| Organization or user | ZHI-QI |
| Repository | pi-okf-memory |
| Workflow filename | npm-publish.yml(只填文件名,不带路径) |
| Environment name | 留空 |
| Allowed actions | 勾上 npm publish |
这个配置动作本身需要 2FA,所以只能人工在网页完成一次。 该端点对尚未发布的包名也可用 —— 也就是说可以先配好,再让 CI 发第一个版本。
之后两条发布路径
| 方式 | 行为 |
|---|---|
| 发一个 GitHub Release | 自动发布到 npm(打 latest 标签) |
| Actions → npm-publish → Run workflow | 默认 dry_run = true 只做校验;确认后把开关关掉再跑 |
workflow 会在发布前依次拦截:
pnpm test全绿(typecheck + 构建 + 266 断言;含需要真实pi进程的 RPC 测试层)- npm 版本 < 11.5.1 → 拦(trusted publishing 的硬要求)
- Release tag 与
package.json版本不一致 → 拦 - 该版本已存在于 npm → 拦(防重复发布)
- 包内容缺少
src/或lib/→ 拦
最后一条是关键守卫:lib/ 在 .gitignore 里,CI 是干净 checkout。
package.json 的 prepublishOnly 会在 npm publish 时自动构建,避免发出残缺包。
本地发布
本地发布需要交互式 2FA,适合首次破壳或 token 路子完全走不通时:
npm login          # 浏览器 / OTP 完成 2FA
npm publish --access public
已有一个 node scripts/release.mjs 脚本(bump 版本 → 构建 → dry-run → 发布),但它走 token 路子,
在当前的 npm 政策下已不可用,仅作参考保留。
License
MIT