pi-vlm-proxy
Generic vision proxy extension for pi: lets non-multimodal models (e.g. DeepSeek) delegate image analysis to ANY OpenAI-compatible multimodal model. Zero vendor hardcoding - a model is just baseUrl + apiKey + model id. Auto-hides itself when the main mode
Package details
Install pi-vlm-proxy from npm and Pi will load the resources declared by the package manifest.
$ pi install npm:pi-vlm-proxy- Package
pi-vlm-proxy- Version
0.1.1- Published
- Aug 3, 2026
- Downloads
- 134/mo · 14/wk
- Author
- lawrencewzen
- License
- MIT
- Types
- extension
- Size
- 46.7 KB
- Dependencies
- 0 dependencies · 2 peers
Pi manifest JSON
{
  "extensions": [
    "./extensions/index.ts"
  ],
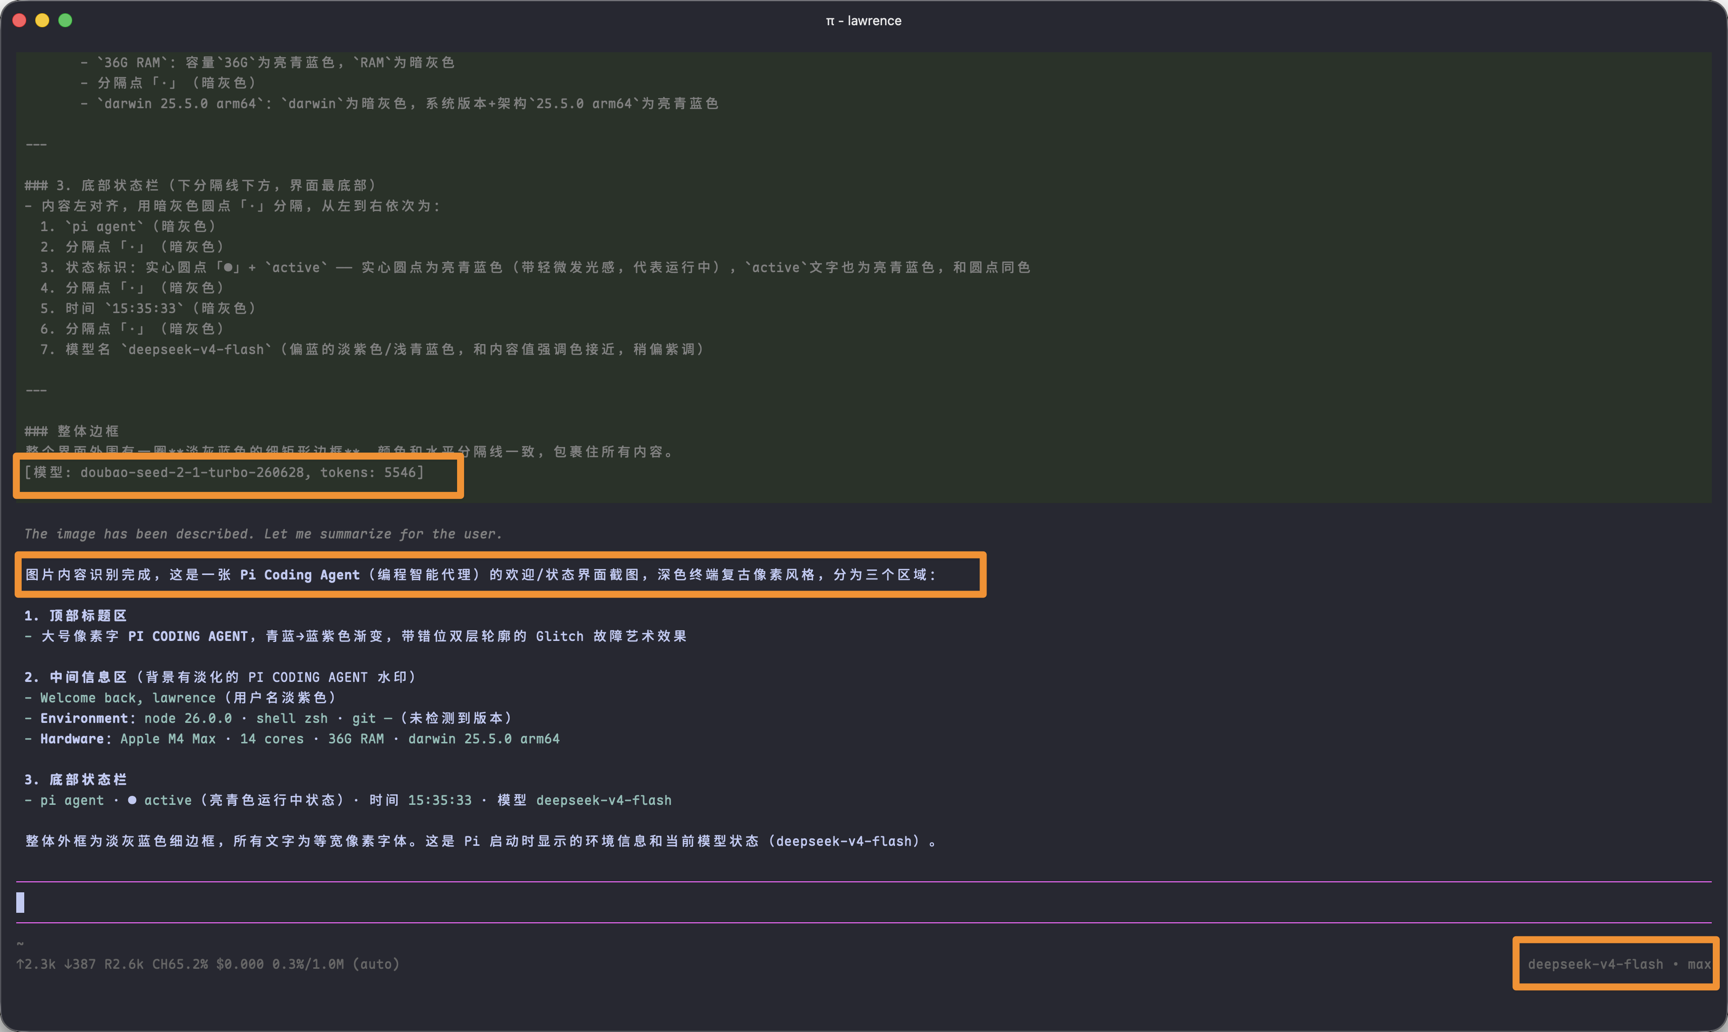
  "image": "https://raw.githubusercontent.com/lawrencewzen/pi-vlm-proxy/main/assets/preview.png"
}
Security note
Pi packages can execute code and influence agent behavior. Review the source before installing third-party packages.
README
pi-vlm-proxy
通用视觉代理扩展 —— 让非多模态模型(DeepSeek、纯文本 LLM 等)通过
describe_image工具,把图片识别委托给任意 OpenAI 兼容的多模态模型。
特性
- 🔌 零厂商硬编码:不内置任何厂商,配一个模型只需 API 地址 + API Key + 模型 ID 三样
- 🌐 兼容所有 OpenAI 格式端点:火山 Ark、阶跃 StepFun、OpenAI、通义 Qwen-VL、智谱 GLM、Gemini(OpenAI 兼容层)、OpenRouter、硅基流动、本地 vLLM / Ollama / llama.cpp……
- 🧠 能力感知透传:主模型是多模态(如 Qwen-VL)时图片原生直发主模型、自动隐藏
describe_image,零额外 API 调用;主模型 text-only(如 DeepSeek)时自动启用代理——无需任何手动操作,切换模型即自动同步 - 🎛️ 命令只有 5 个:
list/add/edit/remove/use,或直接/vision开面板 - 🔑 API Key 安全:支持
$ENV_NAME引用环境变量,配置文件中不落明文 - 🖼️ 两种传图方式:本地文件路径
path/ base64data(兼容粘贴截图)
安装
方式一:本地目录(开发/自用)
在 ~/.pi/agent/settings.json 中注册:
{
  "extensions": ["/path/to/pi-vlm-proxy"]
}
然后 /reload 或重启 pi 生效。
方式二:Git / npm(发布后)
pi install npm:pi-vlm-proxy
# 或
pi install git:github.com/lawrencewzen/pi-vlm-proxy
配置
配置文件:~/.pi/agent/vision-config.json
{
  "current": "my-vision",
  "passthrough": "auto",
  "providers": {
    "my-vision": {
      "baseUrl": "https://api.example.com/v1",
      "apiKey": "$MY_VISION_KEY",
      "model": "vision-model-id",
      "headers": { "x-custom": "value" },
      "maxTokens": 4096
    }
  }
}
| 字段 | 必填 | 说明 |
|---|---|---|
current |
否 | 当前使用的模型名(不填则用第一个) |
passthrough |
否 | 透传模式,默认 auto。无命令入口,只能手改本文件(见下) |
providers.<name>.baseUrl |
✅ | OpenAI 兼容地址,自动补 /chat/completions |
providers.<name>.apiKey |
否 | 明文或 $ENV_NAME(默认 Authorization: Bearer) |
providers.<name>.model |
✅ | 模型 ID |
providers.<name>.headers |
否 | 额外请求头。只有同名的 Authorization 才会覆盖默认 Bearer,配其它头不影响鉴权 |
providers.<name>.maxTokens |
否 | 输出上限,默认 4096 |
透传模式(passthrough)
| 值 | 行为 |
|---|---|
auto(默认) |
主模型 input 含 "image" → 图片原生透传、隐藏 describe_image;text-only → 启用代理 |
on |
强制透传,始终隐藏 describe_image |
off |
强制代理,始终启用 describe_image |
模式在模型切换时自动同步(/model、Ctrl+P、会话恢复),切换即生效并提示。多模态主模型下粘贴/拖拽的图片由 pi 原生发给模型,完全不影响正常使用。
auto 覆盖绝大多数情况,所以没有对应的子命令。留这个字段是给 auto 判断失灵时的逃生阀(主模型元数据没标 image,或标了却调不通),手改配置文件即可强制。
命令
| 命令 | 说明 |
|---|---|
/vision |
打开面板:顶部铺出全部模型 + 当前状态,下方是操作菜单 |
/vision list |
列出所有已配置模型 |
/vision add |
添加模型(名称 → API 地址 → API Key → 模型 ID) |
/vision edit [name] |
编辑已有模型(逐字段提示当前值:留空 = 不变,apiKey 输入 - = 清除) |
/vision remove [name] |
删除模型(有确认) |
/vision use [name] |
切换当前视觉模型(无参数弹出选择列表) |
edit / remove / use 的 [name] 可省略,省略时弹出选择列表;带参数时支持 Tab 补全。
面板长这样:
Vision 设置面板
⚙️ 主模型 deepseek-chat 不支持视觉 → 由 describe_image 委托下面的模型识别

📋 视觉模型 (2):
  ● doubao  (doubao-seed-2-1-turbo-260628 @ https://ark.cn-beijing.volces.com/api/v3)
    stepfun (step-3.7-flash @ https://api.stepfun.com/v1)

  1. 切换当前模型 (use)
  2. 添加模型 (add)
  3. 编辑模型 (edit)
  4. 删除模型 (remove)
  0. 退出
LLM 使用(describe_image 工具)
主模型(如 DeepSeek)看到图片时会自动调用:
describe_image(path: "/path/to/screenshot.png")
describe_image(data: "data:image/png;base64,....", mimeType: "image/png")
- 粘贴截图:pi 会把剪贴板图片写入
/tmp/pi-clipboard-*.png并自动插入路径文本,主模型会拿着路径调用工具 - 磁盘图片:直接告诉主模型图片路径即可
个人配置示例(非包内代码)
你的个人模型配置只存在于 vision-config.json,包本身不包含任何厂商信息:
{
  "current": "volcengine",
  "providers": {
    "volcengine": {
      "baseUrl": "https://ark.cn-beijing.volces.com/api/v3",
      "apiKey": "$VOLC_ARK_KEY",
      "model": "doubao-seed-2-1-turbo-260628"
    },
    "stepfun": {
      "baseUrl": "https://api.stepfun.ai/v1",
      "apiKey": "$STEPFUN_KEY",
      "model": "step-3.7-flash"
    }
  }
}
⚠️ 别把「视觉生成」模型配进来
厂商说的「视觉」经常指视觉生成,而本扩展要的是视觉理解:
| 用途 | 例子 | 能用吗 | |
|---|---|---|---|
| 视觉理解(VLM) | 传图 → 出文字 | doubao-*-vision、qwen-vl-*、glm-4.5v、gpt-4o |
✅ 就要这个 |
| 视觉生成 | 文字 → 出图/视频 | Seedream(文生图)、Seedance(文生视频)、DALL·E、Flux | ❌ 调不通 |
火山引擎尤其容易踩:控制台「视觉」tab 里列的全是 Seedream / Seedance, 识图模型反而在**「语言」tab** 下(多模态理解归在语言模型里)。
开发
# 类型检查
npm run typecheck
# 单元测试(61 项,用本地假端点 + 隔离的 HOME,不发真实请求、不碰真实配置)
npm test
# 在 pi 里加载本地扩展试用
pi -e ./extensions/index.ts
测试分三块:test/config.test.ts(读写、脱敏、原子写)、test/vision.test.ts(鉴权头、
超时、响应形态、体积上限、类型嗅探)、test/commands.test.ts(用假 ExtensionAPI 驱动真实
/vision 命令与 describe_image 工具)。test/test-image.ts 是生成测试用 PNG 的夹具,不参与打包。
若干行为约定
- 鉴权:
headers里没有Authorization(大小写不敏感)时才自动补Bearer <apiKey> - 超时:单次请求 120s 兜底;主动取消不算失败,工具返回普通结果而非错误
- 体积:图片上限 10MB,超限在本地就拒绝,不会发出去换一个看不懂的 413
- 截断:响应
finish_reason为length时会在结果末尾提示调大maxTokens - 配置:写入走「临时文件 + rename」,权限固定
600;原文件损坏时先备份为.bak - 兼容:请求体用
max_tokens。要求max_completion_tokens的新版 OpenAI 端点暂不支持