pi-web-search-lite
Pi extension: lightweight web_search + web_fetch with configurable search provider and fetch chain.
Package details
Install pi-web-search-lite from npm and Pi will load the resources declared by the package manifest.
$ pi install npm:pi-web-search-lite- Package
pi-web-search-lite- Version
0.6.0- Published
- Oct 11, 2026
- Downloads
- 693/mo · 693/wk
- Author
- setwhite
- License
- MIT
- Types
- extension
- Size
- 143.2 KB
- Dependencies
- 1 dependency · 3 peers
Pi manifest JSON
{
  "extensions": [
    "./index.ts"
  ]
}
Security note
Pi packages can execute code and influence agent behavior. Review the source before installing third-party packages.
README
简体中文 | English
pi-web-search-lite
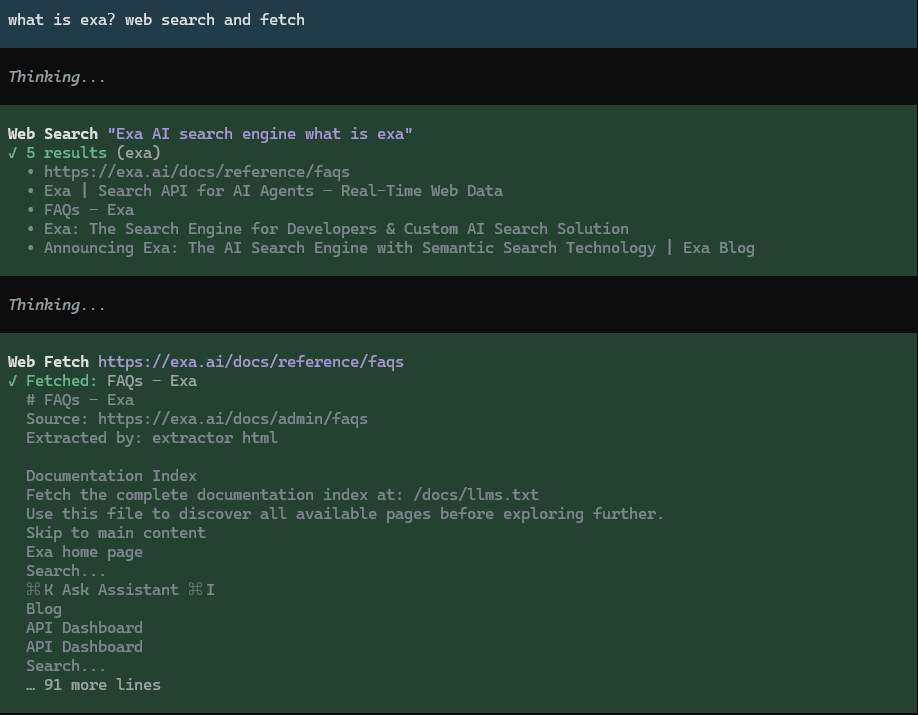
给 pi 加两个工具:web_search 搜网页、web_fetch 抓网页正文;所有出站请求走同一个代理。
安装
pi install npm:pi-web-search-lite                        # 从 npm 安装
pi install git:github.com/setwhite/pi-web-search-lite    # 从 git 仓库安装
装完配一个搜索 key 就能用,不需要构建。
配置
配置只有一个 JSON 文件:<PI_CODING_AGENT_DIR 或 ~/.pi/agent>/pi-web-search-lite/config.json,不存在时全用默认值。类型、枚举名或未知键写错,启动会失败并指出字段;数值越界不报错,静默 clamp 到区间(见 config/README.md)。示例里的 // 注释只为讲解,实际文件必须是严格 JSON,拷走前先删掉。
最小可用配置——填上自己的 key 就能用:
{
  "apiKeys": { "tavily": "tvly-你的key" }
}
key 也可以放环境变量(TAVILY_API_KEY / BRAVE_API_KEY / EXA_API_KEY / FIRECRAWL_API_KEY / PERPLEXITY_API_KEY / JINA_API_KEY,优先于文件);换默认搜索源改 provider,也可以用 WEB_SEARCH_PROVIDER 临时覆盖。
完整示例——列全所有配置项,每个键都有注释;除 key、userAgent、proxy 和 guidance 是示例值外,其余就是默认值:
{
  // 搜索源:tavily | brave | exa | firecrawl | perplexity;可用 WEB_SEARCH_PROVIDER 环境变量覆盖
  "provider": "tavily",
  // API key:需要哪个源就填哪个键,也可以改用环境变量(环境变量优先)
  // 环境变量名:TAVILY_API_KEY / BRAVE_API_KEY / EXA_API_KEY / FIRECRAWL_API_KEY / PERPLEXITY_API_KEY / JINA_API_KEY
  "apiKeys": {
    "tavily": "tvly-你的key",
    "brave": "你的key",
    "exa": "你的key",
    "firecrawl": "fc-你的key",
    "perplexity": "pplx-你的key",
    "jina": "jina-你的key"
  },

  // 代理:所有出站请求的唯一出口;"" = 直连
  "proxy": "",
  // 请求超时(毫秒)
  "timeoutMs": 30000,
  // 出站 User-Agent:不写则自动用「包名/版本」,写了就按写的发
  "userAgent": "my-agent/1.0",

  // 工具开关与改名;改成别的名字可避开与其它扩展重名
  "tools": {
    "web_search": { "enabled": true, "name": "web_search" },
    "web_fetch": { "enabled": true, "name": "web_fetch" }
  },
  // eager:工具常驻上下文;deferred:由宿主 tool_search 按需发现,更省上下文
  "activation": "eager",

  // 覆盖内置提示词;不配就用内置的英文单行。每个工具(web_search / web_fetch)可覆盖三个字段:
  //   description        工具描述,会进入工具检索的语料,建议英文
  //   promptSnippet      工具列表里的一行短语
  //   promptGuidelines   系统提示 Guidelines 区的规则,字符串数组
  "guidance": {
    "web_search": {
      "description": "Search the web; returns titles, URLs and snippets.",
      "promptSnippet": "Search the web",
      "promptGuidelines": ["web_search: cite sources as [Title](URL) links."]
    },
    "web_fetch": {
      "description": "Extract content of URL.",
      "promptSnippet": "Extract URL text",
      "promptGuidelines": ["web_fetch: use to get full text of a URL, e.g. docs or URLs found by web_search."]
    }
  },
  // 真正进模型的那道闸:内容超过任一上限就截断;null = 用宿主默认上限,写大于宿主上限的值不生效
  "context": {
    "maxInlineChars": null,  // 按字节截断(下限 1000,写小了会被抬到 1000)
    "maxInlineLines": null,  // 按行截断(下限 50)
    "spillToFile": true      // 截断时把完整文本写到 <tmp>/pi-web-search-lite-*/web-{search,fetch}.md,路径回填进结果供 read 续读;false = 全文丢弃
  },
  // 搜索条数:不传时给多少、最多允许多少
  "search": { "defaultMaxResults": 5, "maxResultsLimit": 10 },
  // 抓取:extractors 是 fallback 链,按顺序挨个试,第一个能用的胜出;缺 key、报错、正文太短都顺延下一个
  // 推荐顺序 html → 你的 provider(tavily / exa / firecrawl)→ jina;html 和 jina 都不需要 key
  "fetch": {
    "extractors": ["html", "jina"],
    "minChars": 200,
    "allowRaw": false,               // 打开后 web_fetch 才会多出 raw 参数(返回原始响应,跳过 handler 与提取器链)
    "maxCharsPerPage": 150000        // 单页正文上限,见下方「三道 max 闸」
  },
  // 专用页面优先交给对应 handler:github 直接用 gh 的输出,reddit 只换域名后交给提取器链;跳过(失败或关掉)→ 透明顺延,原因记在 details.handlerSkips
  "handlers": {
    "github": {
      "enabled": true,     // false = 完全不碰 gh,GitHub URL 走提取器链
      "command": "gh",     // execFile 直连、不经 shell:只能写可执行文件(PATH 名或绝对路径),不能带参数;Windows 上 .cmd/.bat 会失败
      "timeoutMs": 30000,  // 每个 gh 子进程的超时;可用性探测按 command 在进程内缓存,改完要 /reload
      "maxChars": 150000   // gh 输出渲染成 markdown 后的截断上限,见下方「三道 max 闸」
    },
    "reddit": {
      "enabled": true,    // false = 不换域名,reddit URL 原样走提取器链(不想把链接交给第三方实例就关掉)
      "baseUrl": "https://redlib.catsarch.com"  // reddit 只换域名(path 照抄)交给 redlib 实例,正文仍由提取器链抓;可填自建实例,带子路径也行
    }
  }
}
每个键都可省略。默认值与取值范围见 config/README.md;要覆盖提示词就往 guidance.web_search / guidance.web_fetch 里填字段。
三道 max 闸,别混
抓取结果从出网到进模型要过三层上限,各自独立截断:
| 键 | 作用对象 | 超限后果 |
|---|---|---|
fetch.maxCharsPerPage |
提取器链拿回的正文(不含 GitHub handler) | 切片 + 追加 [... truncated ...],原始全文不再保留 |
handlers.github.maxChars |
gh 输出渲染成 markdown 之后 | 同上;只作用于 GitHub handler |
context.maxInlineChars / maxInlineLines |
组装好、要发给模型的信封(两个工具都过) | 切片;spillToFile 为真时完整文本落临时文件,路径写进结果 |
context.* 两个上限用 Math.min 夹到宿主上限,写大了不生效;GitHub 页面只过第 2、3 道,普通网页只过第 1、3 道。支持的 GitHub / Reddit URL 形态见 handlers/README.md。
功能
- 搜网页:tavily / brave / exa / firecrawl / perplexity 任选一个,不会偷偷换源;缺 key 会直接告诉你配哪里。
- 抓网页:提取器是 fallback 链,按顺序挨个试、第一个能用的胜出(默认
html→jina,两位都不需要 key;tavily/exa/firecrawl可以插到中间)。GitHub 页面优先用gh,reddit 默认把域名换成 redlib 实例(两者见handlers/README.md);fetch.allowRaw打开后才有raw参数,raw 跳过整条链。 - 安全与省心:内网 / 回环地址直接拒绝,重定向逐跳复查;结果太长自动截断,
context.spillToFile为真时全文落到临时文件(路径写进结果)。 - 上下文可控:工具可改名、可关闭、可改成按需发现,减少常驻提示词。
- 提示词精简:内置提示词是英文单行;续读提示、key 位置、参数范围这些信息都由报错和结果给出,不占提示词;工具改名后提示词自动跟着变。
环境要求
- pi 宿主(Node 版本随宿主要求)。
ghCLI 可选:只有抓 GitHub 页面会用到,没装不影响其它功能。
参考项目
- nicobailon/pi-web-access —— 提取器链与专用页面 handler 的思路来源。
- juicesharp/rpiv-mono · rpiv-web-tools —— 薄 provider 层、提示词配置面与 TUI 渲染的参考。
两个项目都完整开源,本项目的取舍基于它们的代码。
文档索引
- 设计目标与取舍:
docs/PLAN.md - 模块划分与依赖方向:
docs/ARCHITECTURE.md - 任务台账:
docs/TODO.md - 模块 API 与契约:各目录下的
README.md(config/、http/、ssrf/、providers/、handlers/、extractors/、tools/)
开发
pnpm install
pnpm test        # 单元测试,不打真实网络
pnpm typecheck
CI 在 Linux 与 Windows 上跑这两条命令;pnpm 版本由 packageManager 字段锁定。